
在自己电脑上,搭一套会“自我学习”的EL缺陷识别AI
导读
EL(电致发光)是组件厂最常用的“X光”:隐裂、断栅、黑芯、虚焊,在EL图上一目了然。但一条产线每天成千上万张EL图,全靠判片员盯着屏幕看——看久了会累,换人了标准会变,老师傅走了经验也跟着走。这篇我们不讲论文,只做一件事:手把手在自己电脑上搭一套能用的EL自动识别程序,而且让它越用越准。全文不需要你会写代码,跟着做即可。
01先看全貌:这套系统由哪三部分组成
很多人一听“AI自我学习”,以为是程序自己琢磨、自己进步。在工厂里,可靠的做法恰恰相反:机器负责“看”,人负责“教”,再加一个公平的“考场”负责把关。三者缺一不可。
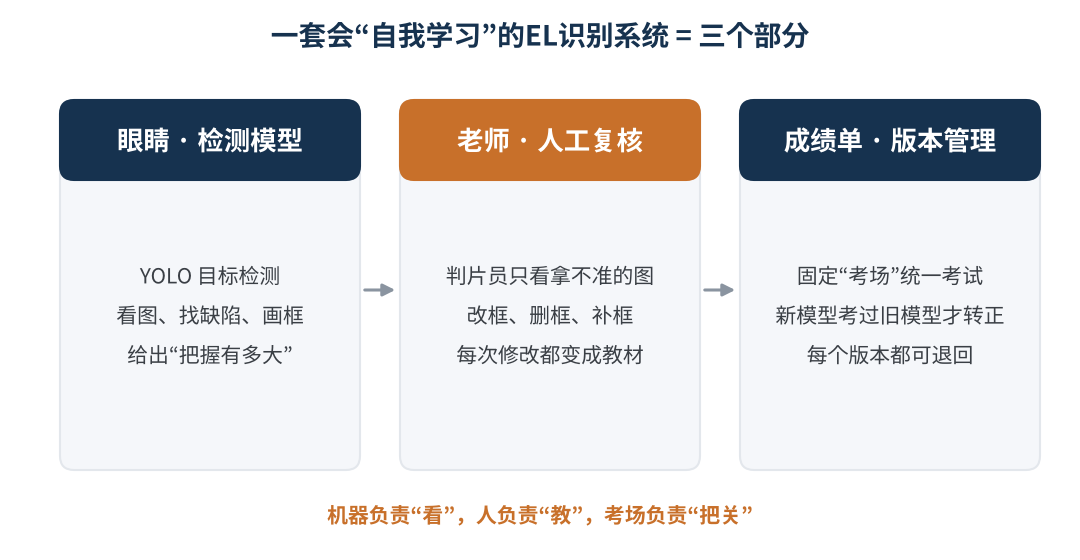
图1 会“自我学习”的EL识别系统由三部分组成
- 眼睛:检测模型。我们用开源的YOLO目标检测模型。它看一张EL图,就能把缺陷框出来,说出是哪一类,并给出一个0~1之间的“把握”(置信度)。
- 老师:人工复核。AI拿不准的图,交给判片员看。判片员在标注软件里改框、删框、补框,每一次修改都会变成新的“教材”。
- 成绩单:版本管理。准备一个固定不变的“考场”。每次学习后,新模型和旧模型在同一个考场考试,新的考过了才转正,没考过就继续用旧的。
为什么选YOLO?它开源、文档全,几行代码就能训练自己的模型。Ultralytics在2026年1月发布了YOLO26,采用无需NMS的端到端设计,主打在普通CPU和边缘设备上跑得快,目前是官方推荐的模型;下一代YOLO27已在YOLO Vision 2026发布会上亮相,官网目前标注为“即将推出”,尚未公布具体日期。本文代码用YOLO26,以后换新模型只需改配置文件里的一个名字。
为什么在自己电脑上跑?EL图是工厂的核心数据,里面藏着片源、工艺和良率信息。本地运行,数据不出电脑,断网也能用,这对很多工厂来说是硬要求。
这套系统的核心不是“模型多先进”,而是“眼睛 + 老师 + 考场”的配合:AI看大部分图,人只教AI拿不准的,考场保证每次升级都是真进步。
02准备工作:一台电脑、三个软件
先看电脑。不需要专门买服务器,办公室里一台带独立显卡的台式机就够用;没有显卡也能跑,只是训练慢很多。
| 项目 | 能跑起来 | 推荐配置 |
|---|---|---|
| 系统 | Windows 10/11(64位) | 同左 |
| 显卡 | 无(用CPU,训练很慢) | NVIDIA独显,显存8GB及以上 |
| 内存 | 16GB | 32GB |
| 硬盘 | 剩余50GB | 固态硬盘,剩余200GB以上 |
表1 电脑配置建议
再装三个软件,按顺序来:
- ① Python 3.12。到python.org下载安装,安装界面第一页一定要勾选“Add python.exe to PATH”。
- ② PyTorch(有N卡才需要这一步)。打开pytorch.org首页,在选择器里选Windows、Pip、Python和对应的CUDA版本,复制它给出的命令到命令行运行。
- ③ Ultralytics。在命令行运行下面这行命令;国内网络建议加上清华镜像。
pip install ultralytics

# 国内网络慢时,改用清华镜像:
pip install ultralytics -i https://pypi.tuna.tsinghua.edu.cn/simple

# 检查显卡:True=GPU就绪,False=用CPU
python -c "import torch; print(torch.cuda.is_available())"
最后装一个标注软件。我们推荐开源的X-AnyLabeling:界面中文,能读写YOLO格式,还能直接调用YOLO模型做“预标注”,正好用在后面的人工复核环节。
然后解压代码包,双击“0_初始化文件夹.bat”,所有需要的文件夹就自动建好了(见图3)。小提示:第一次训练时程序会自动从GitHub下载预训练模型,如果下载失败,可以手动下载yolo26s.pt放到代码文件夹里。
03数据:把“判定标准”翻译成“标注规范”
这是全篇最重要的一节。模型能做到多好,上限由数据决定;而EL数据的质量,本质上就是判定标准的一致性。同一种暗线,A判片员标“隐裂”,B判片员标“划伤”,模型就会无所适从。
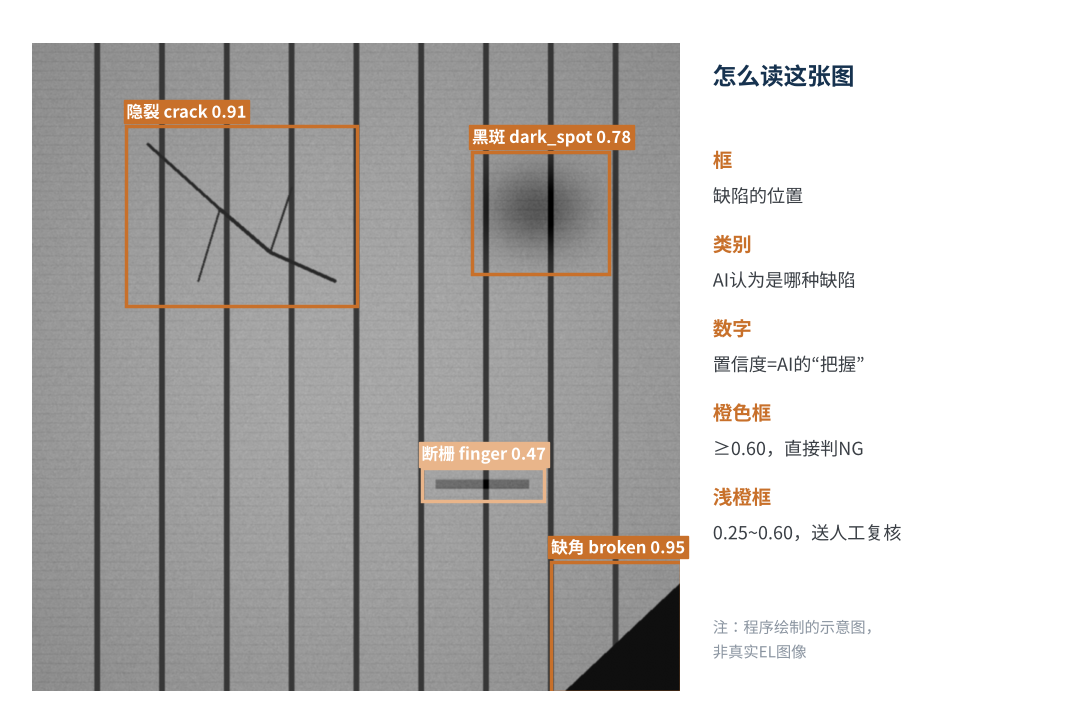
图2 EL缺陷识别的输出长什么样(示意图)
下面是我们代码里预设的8个类别,可以直接用,也可以按你们工厂的标准改:
| 代号 | 缺陷 | EL上的典型表现 | 标注要点 |
|---|---|---|---|
| crack | 隐裂 | 暗色细线,线状、树枝状或星状 | 框住整条裂纹,交叉裂纹框成一个 |
| finger | 断栅 | 沿细栅方向的条状暗区 | 框住暗区即可 |
| black_core | 黑芯 | 片子中心区域整体发暗,常呈同心圆 | 框住发暗区域 |
| dark_spot | 黑斑/暗片 | 局部或整片亮度偏低 | 局部框暗区,整片暗就框整片 |
| short_circuit | 短路黑片 | 整片几乎全黑 | 框整片 |
| broken | 碎片/缺角 | 边角缺失或碎裂,边界清晰 | 框缺失区及周边裂纹 |
| scratch | 划伤 | 细长暗线,通常较直 | 与隐裂易混,规范里要附对比图 |
| solder_defect | 焊接不良 | 沿焊带两侧的暗区或亮度不均 | 框住异常的那一段 |
表2 预设的8个缺陷类别
这份清单只是示例。类别怎么分,就按你们现有的EL判定标准来;原则是宁少勿多,相似难分的先合并,等数据多了再拆。
标注时守住三条铁律:
- 同一把尺子。把判定标准写成带示例图的“标注规范”;多人标注前,先拿同一批图各标一遍,对齐分歧后再开工。
- 框要贴。框住缺陷本身,不留大片空白,也不要切掉缺陷的一部分。
- 好片也要有。无缺陷的图也放进训练集,标签留空,让模型知道“什么是好片”,否则它会到处“找茬”。
数据量方面,经验上每类缺陷先攒到一两百个样本,总量几千张图,就能训练出一个可用的起点。手上还没有数据的,可以先用公开数据集练手:PVEL-AD由河北工业大学和北京航空航天大学联合发布,有36543张近红外EL图、12类缺陷(另含无缺陷图)和标注框,需填写签字申请表并用机构邮箱申请;ELPV由德国ZAE Bayern等机构发布,有2624张300×300的单片灰度图,但标的是“缺陷概率”而不是框,更适合做分类练习。
要提醒的是,这些公开数据以早期多晶、单晶片为主,和现在的TOPCon、HJT、多主栅/0BB片子在EL形貌上差别不小,只适合练手,不能直接拿来上线。
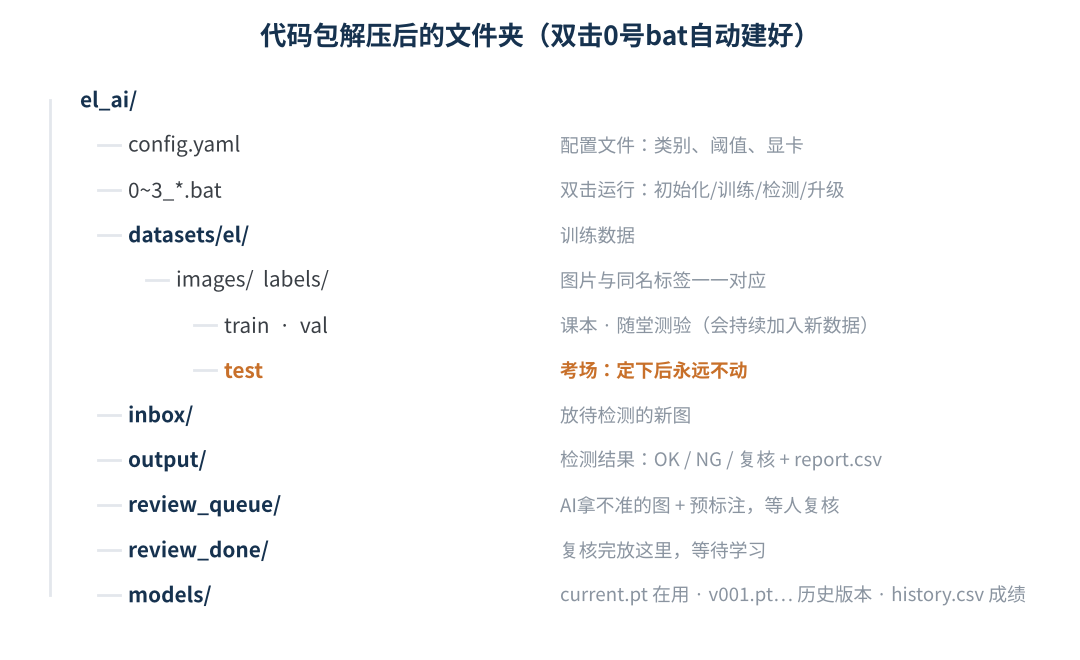
图3 代码包的文件夹结构
数据要分成三份:训练集(train)相当于课本,验证集(val)相当于随堂测验,测试集(test)相当于期末考场,比例大约8:1:1。考场一旦定下,永远不再改动——后面每一次“升级”的判断都靠它。考场里要覆盖各类缺陷、各条产线和各台EL设备的图。
标注规范就是判定标准的“数字版”。先统一标准再标注,比换任何更先进的模型都管用。
04第一次训练:让模型“入门”
打开config.yaml(用记事本就行),通常只需要确认三处:有没有显卡、用多大的模型、缺陷类别。
# 起点模型:n更快、s均衡、m更准
model_base: yolo26s.pt

# 单片图用640;细小缺陷多可试1024
imgsz: 640

# 有NVIDIA显卡填0;没有填 cpu
device: 0

# 缺陷类别,顺序定下后不再改
classes: [crack, finger, black_core,
  dark_spot, short_circuit, broken,
  scratch, solder_defect]
改好后双击“1_首次训练.bat”。程序会依次做四件事:读取数据 → 从预训练模型出发训练 → 在考场考试 → 把模型存为v001。核心代码只有几行:
from ultralytics import YOLO

# 加载预训练模型
model = YOLO("yolo26s.pt")

# 开始训练:EL图上下、左右翻转都合理;
# 灰度图,关掉色彩增强
model.train(data="data.yaml",
    epochs=100, imgsz=640,
    fliplr=0.5, flipud=0.5,
hsv_h=0.0, hsv_s=0.0)为什么几千张图就够?因为预训练模型已经在海量图片上学会了“看边缘、看纹理、看形状”,我们只是教它认识EL缺陷,这叫迁移学习。训练时间取决于图片数量和显卡,几千张图在主流独显上通常是几十分钟到几小时;纯CPU可能要一天以上。
训练完会给出一组成绩,看懂这四个数就够了:
| 指标 | 通俗含义 | 低了意味着 |
|---|---|---|
| 精确率 Precision | AI判NG的图里,真NG占多少 | 误判多,复判工作量大 |
| 召回率 Recall | 真NG的图里,AI抓到了多少 | 漏检多,缺陷片流到下游 |
| mAP50 | 框的位置大致对就算对的综合分 | 整体识别能力弱 |
| mAP50-95 | 对框的位置要求更严的综合分 | 框得不准 |
表3 看懂四个训练指标
对EL来说,召回率比精确率更要紧:误判一张,判片员多看一眼;漏检一张,可能就是一块隐裂组件到了电站。所以后面的升级规则里,召回率是“一票否决”项。训练结束后,runs文件夹里还有一张混淆矩阵图,能看出每一类缺陷分别学得怎么样。
05上线检测:把“拿不准”的图挑出来
日常使用很简单:把新的EL图放进inbox文件夹,双击“2_检测新图.bat”。和常见的“OK/NG二选一”不同,我们让程序分三路走:
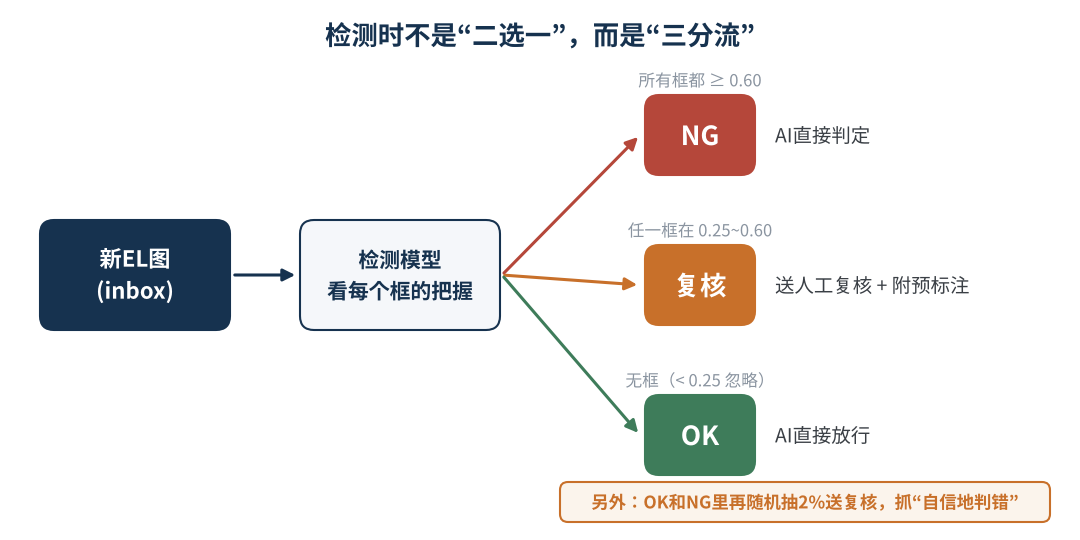
图4 检测结果“三分流”
- NG:所有缺陷框的置信度都在0.60以上,AI直接判定。
- 复核:只要有一个框的置信度落在0.25~0.60之间,就送人工复核,并附上AI的预标注。
- OK:没有任何框(低于0.25的框忽略),AI直接放行。
置信度可以理解为AI的“把握”。把握大的交给AI,把握小的交给人——AI省掉的是大量“一眼就能判”的图,人只看真正难的那部分。阈值都在配置文件里,可以调:上线初期保守一些,多送复核;模型变准以后再逐步收紧。
另外,程序还会从OK和NG里随机抽2%送去复核。原因是AI最危险的错误不是“拿不准”,而是“很自信地判错”,抽检就是专门抓这类问题的。分流的核心逻辑如下:
if 任一框置信度在0.25~0.60之间:
    判定 = "复核"
elif 有框(且都≥0.60):
    判定 = "NG"
else:
    判定 = "OK"
抽检 = 判定不是复核 且 随机数 < 0.02
每次检测会生成一个带时间的结果文件夹,里面OK、NG、复核三个子文件夹放着画好框的图,report.csv汇总每张图的判定和缺陷,用Excel直接打开。
三分流的意义:让AI承担“确定的多数”,让人专注“不确定的少数”,而人处理这些少数的过程,正是下一节自我学习的原料。
06自我学习:人判一次,模型记一次
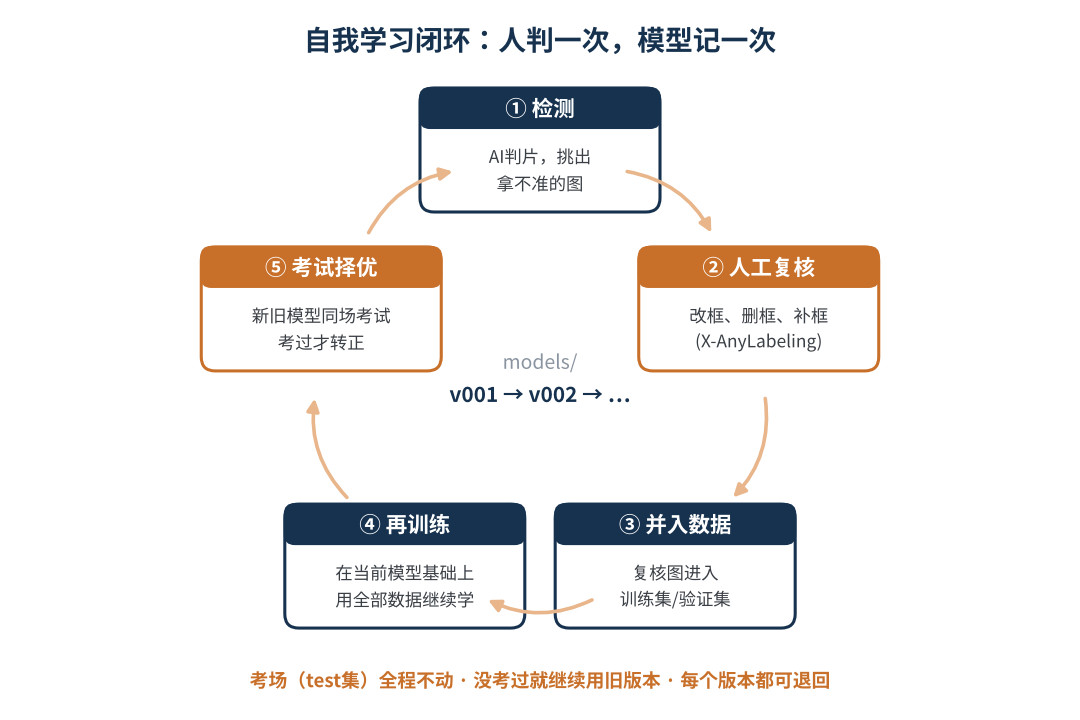
图5 自我学习闭环
检测之后,review_queue文件夹里就攒下了一批“AI拿不准的图 + AI的预标注”。接下来的闭环分五步:
- ① 复核。用X-AnyLabeling打开review_queue里的图片,按YOLO格式导入预标注(类别表classes.txt已经备好),改框、删框、补框;确认是好片的,把框全部删掉。
- ② 移交。把改好的图片和对应的标签文件,一起剪切到review_done文件夹。
- ③ 学习。双击“3_学习升级.bat”。复核图90%进训练集、10%进验证集,然后在当前模型基础上继续训练。
- ④ 考试。新旧模型在同一个考场考试。
- ⑤ 择优。新模型的mAP50-95至少提高0.005,且召回率下降不超过0.01,才转正为新版本;否则继续用旧的。
旧成绩 = 考试(当前模型)
新成绩 = 考试(新训练的模型)
if (新成绩.mAP50_95 - 旧成绩.mAP50_95 >= 0.005
    and 新成绩.召回率 >= 旧成绩.召回率 - 0.01):
    升级为新版本(v002…),旧版本保留
else:
    继续用旧模型,本次成绩记入 history.csv
这里有三个容易被忽略、但决定成败的设计:
- 用全部数据继续训练。只用新图训练,模型会“学了新的、忘了旧的”,这在AI里叫灾难性遗忘。所以每次学习都把新旧数据放在一起。
- 考场永远不动。复核图只进训练集和验证集,不进测试集。否则就像提前把考题给了学生,分数好看,上线就露馅。
- 每个版本都留着。models文件夹保存每一版模型,history.csv记录每次成绩。哪天发现新版本有问题,把旧版本复制成current.pt就能退回。
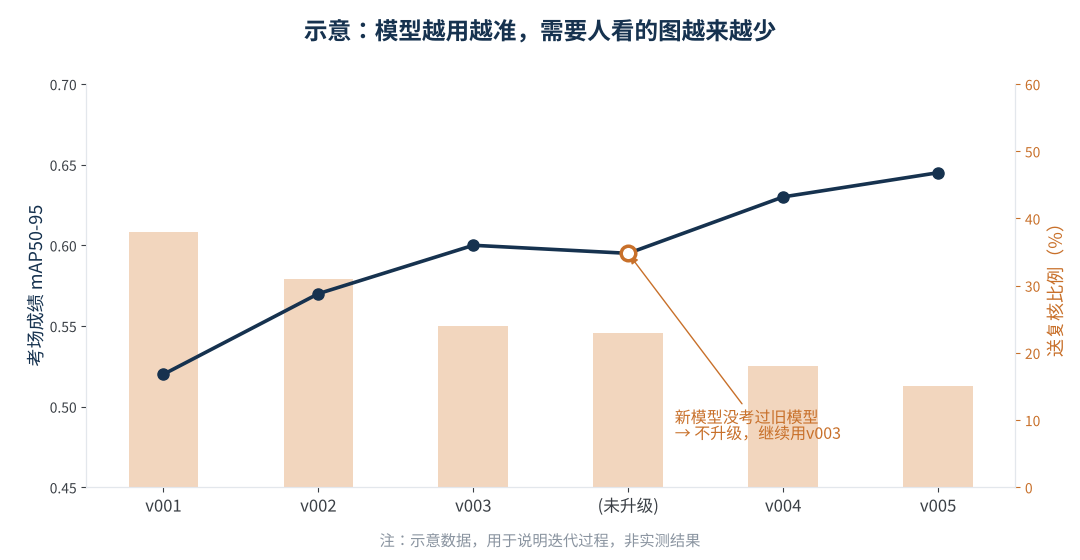
图6 版本迭代示意:考场成绩上升,送复核比例下降
节奏上,攒够一两百张复核图学一次就行,大约一到两周一次。遇到换电池技术路线、换EL设备、出现新缺陷类型时,适当调低阈值,让更多图进入复核。
可能有人会问:为什么不让模型完全自己学,用它自己的判定结果训练自己?因为它判错的图如果再拿来训练,错误会被“强化”,越学越偏。人在环路里,是工业场景的底线。
所谓“自我学习”,本质是把每一次人工复判沉淀成训练数据——判片员的经验不再随人走,而是留在了模型里。
07避坑清单:我们踩过、也见别人踩过的坑
- 标准漂移。不同判片员、不同班次判法不一,模型学到的就是“混乱”。先统一规范,再大规模标注。
- 设备差异。不同EL设备的曝光、分辨率、相机不一样。换设备或新增产线时,先抽几百张图做验证,必要时补一批该设备的数据。
- 整版图直接缩小。组件整版EL图分辨率很高,缺陷相对很小,直接缩到640像素,细隐裂可能就“缩没了”。建议先按电池片切图,或者调大imgsz。
- 类别不平衡。隐裂成百上千,短路黑片寥寥无几。稀有类别要有意识地收集,实在太少就先合并。
- 考场污染。把测试图混进训练集,分数虚高。测试集单独存放,定期检查有没有重复图片。
- 只看总分。mAP总分涨了,某一类(比如隐裂)可能反而变差。升级后看一眼混淆矩阵,重点类别单独盯。
- 开源许可。Ultralytics采用AGPL-3.0开源许可。如果要把程序集成进产品对外销售或提供服务,需要评估开源义务,或向官方购买商业许可。
08写在最后
AI不是来替代判片员的。真正有价值的,是把老师傅“一眼看出这是隐裂还是划伤”的经验,变成一套可复制、可积累、不会随人员流动而流失的能力。
这套程序一个人、一台电脑就能跑起来,试错成本很低。我们建议先在一个工序、一种片型上小范围试点,跑上一两个月,重点看两件事:送复核的比例有没有逐步下降,抽检有没有抓到AI的“自信误判”。这两个数字说明闭环真的在转。
如需本文的完整代码包(含双击运行的bat文件、配置文件和使用说明),或者你在工厂里最想让AI帮忙解决哪个问题,欢迎与我们交流。AI+光伏系列我们会继续更新。
参考资料
- Ultralytics. Models Supported by Ultralytics(YOLO26等);Ultralytics Roadmap
- Ultralytics. Key Highlights from Ultralytics YOLO Vision 2026(YOLO27发布)
- Su B, Zhou Z, Chen H. PVEL-AD: A Large-Scale Open-World Dataset for Photovoltaic Cell Anomaly Detection. IEEE Transactions on Industrial Informatics. github.com/binyisu/PVEL-AD
- Buerhop-Lutz C, Deitsch S, et al. A Benchmark for Visual Identification of Defective Solar Cells in Electroluminescence Imagery. 35th EU PVSEC, 2018. github.com/zae-bayern/elpv-dataset
- Deitsch S, et al. Automatic Classification of Defective Photovoltaic Module Cells in Electroluminescence Images. Solar Energy, 2019, 185: 455-468.
- X-AnyLabeling: A Unified Desktop Platform for AI-Assisted Data Annotation. github.com/CVHub520/X-AnyLabeling
- Ultralytics Licensing(AGPL-3.0与商业许可)
十余年光伏研发与技术团队|硬核专业知识分享
材料 · 可靠性 · 失效分析 · 标准认证 · 产品 · 工艺
AI+光伏探索交流,欢迎合作
声明:
1. 原创内容仅代表作者个人观点,仅供参考,不构成投资建议。
2. 转载及引用内容均注明出处,尊重原创。
3. 部分内容含AI辅助(图表生成、数据检索、概念说明等),核心框架与重点内容由本技术团队撰写,并经人工审核。
4. 如有不实或侵权,请留言或联系我们处理